
Artigo · Data & IA
Integração de dados: mapeie fontes e dependências antes de escolher a tecnologia
Um roteiro prático para relacionar fontes, consumidores, dependências e observabilidade antes de decidir como integrar dados.
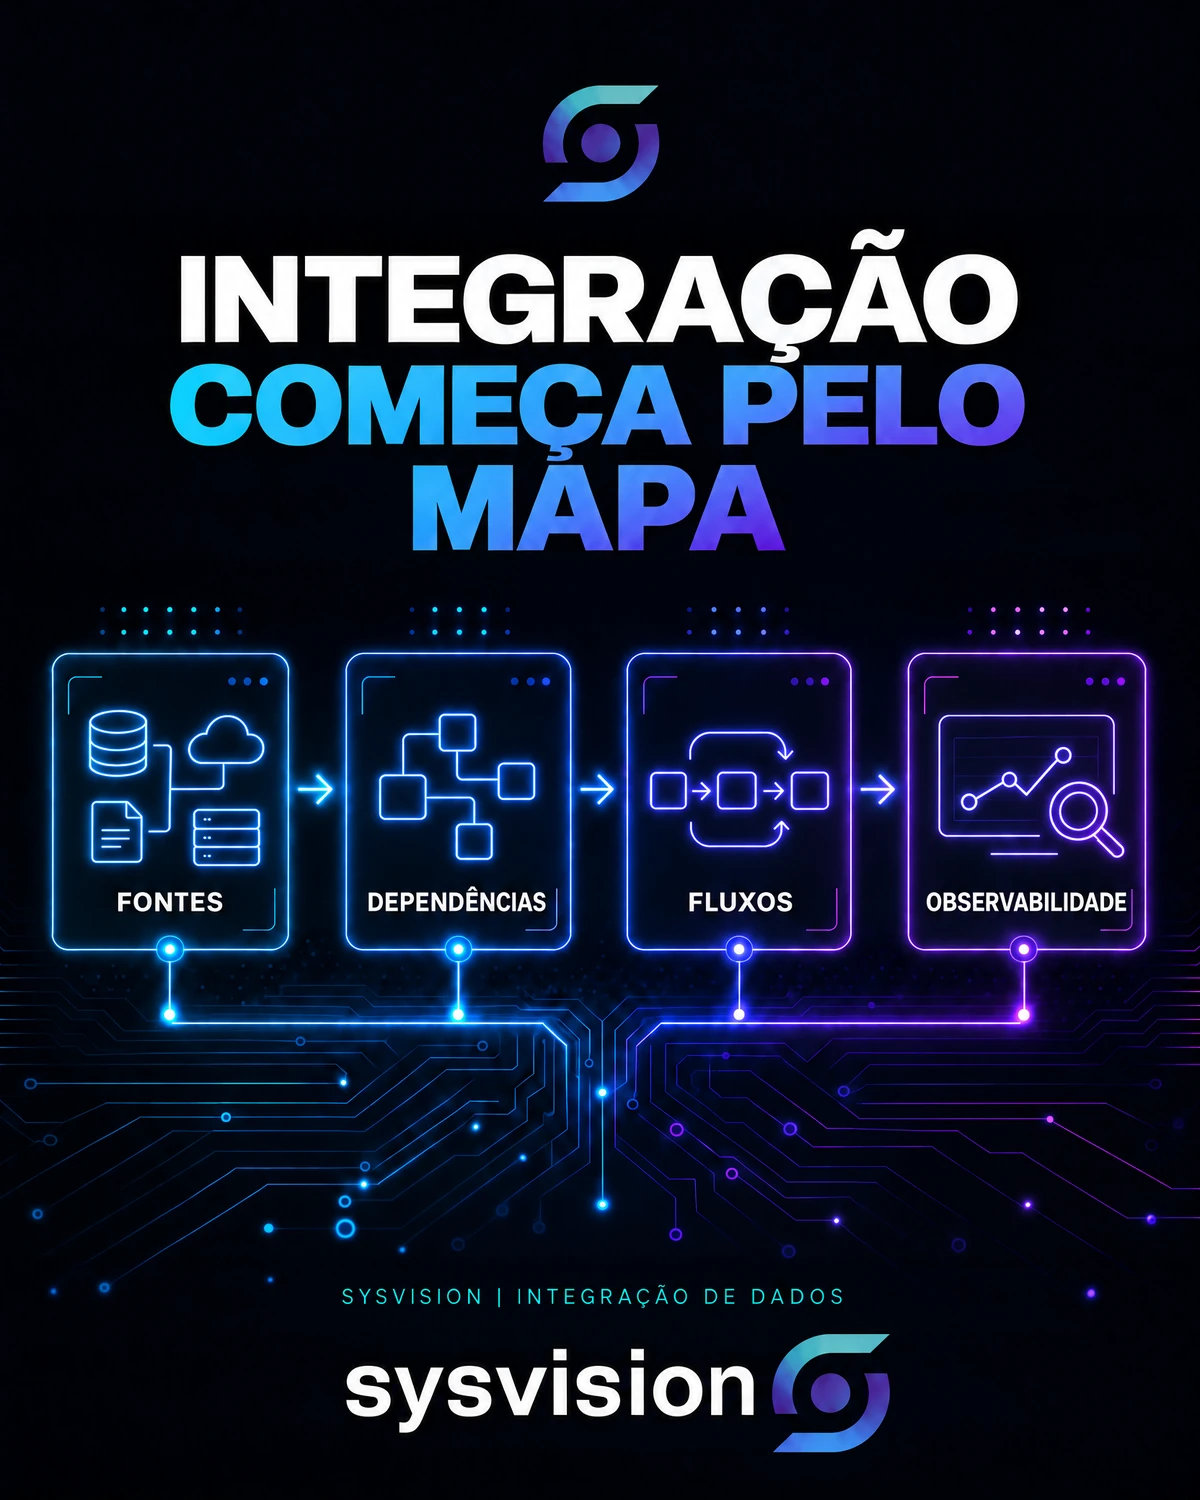
Uma integração de dados começa antes de escolher entre APIs, ETL/ELT ou captura de alterações. Primeiro, é preciso entender quais fontes participam do fluxo, quem consome seus dados, de quais relações o uso depende e como a equipe perceberá mudanças ou falhas. Esse mapa ajuda a discutir mecanismos a partir do ambiente e do caso de uso, em vez de partir de uma arquitetura escolhida antes da descoberta.
1. Comece pelo contexto que precisa conectar
Antes de desenhar uma integração, descreva o fluxo de trabalho que depende dos dados. Que decisão, operação ou informação precisa circular? Quais equipes participam e o que muda se o dado atrasar, vier incompleto ou deixar de chegar?
Esse recorte impede que a conversa comece por uma tecnologia escolhida de antemão. Ele também ajuda a separar o que é requisito do caso de uso do que é preferência de implementação.
Fontes consultadas: [1]
2. Liste fontes e consumidores
Para cada fluxo, registre quais sistemas ou conjuntos de dados participam, quem é responsável por cada fonte, quem consome a informação e para qual finalidade. Uma mesma fonte pode atender consumidores diferentes, com necessidades e regras distintas.
Quando houver lacunas, marque-as como perguntas em aberto em vez de preenchê-las por suposição. Confirme a finalidade, as definições e as condições de acesso com as pessoas que conhecem cada sistema e processo.
- Fonte: sistema, dado ou evento de origem.
- Responsável: pessoa ou equipe que pode esclarecer a definição e a evolução da fonte.
- Consumidor: aplicação, processo, análise ou equipe que usa o dado.
- Finalidade: decisão ou atividade que depende desse uso.
Fontes consultadas: [1]
3. Torne as dependências visíveis
Desenhe as relações entre fontes, transformações e consumidores. Identifique quais fluxos dependem de outros, onde ocorrem conversões ou validações e o que precisa ser coordenado quando uma definição muda.
A intenção não é criar um diagrama complexo por si só. Um mapa simples, validado por quem opera o fluxo, pode revelar perguntas que precisam ser respondidas antes de escolher como mover os dados.
- Que fluxo precisa ocorrer antes de outro?
- Onde os dados são transformados ou combinados?
- Quais definições ou contratos são compartilhados entre consumidores?
- Quem precisa ser envolvido quando uma fonte ou regra muda?
4. Inclua riscos e observabilidade no desenho
Pergunte como a equipe perceberá que um fluxo deixou de atender ao uso previsto. Defina quais mudanças, atrasos, falhas ou divergências precisam ser notados e quem deve receber essa informação.
O sinal relevante depende do processo. Não é necessário inventar um indicador genérico: descreva primeiro o comportamento que precisa ser observado e combine com os responsáveis como identificar e tratar uma exceção.
- Qual condição indica que uma atualização não chegou como esperado?
- Como diferenciar atraso, falha e mudança legítima na origem?
- Onde a equipe consulta o estado do fluxo e seu histórico?
- Quem decide o próximo passo quando o sinal aparece?
Fontes consultadas: [2]
5. Compare os mecanismos depois da descoberta
Com o contexto mapeado, avalie alternativas como APIs, ETL/ELT, captura de alterações de dados (CDC) e orquestração em relação às necessidades do fluxo. A página de Soluções da SYSVISION descreve essas capacidades como opções de integração a serem desenhadas conforme as fontes e dependências do ambiente.
Compare o que cada alternativa precisa resolver no caso concreto: forma de consumo, frequência de atualização, transformações, tratamento de exceções e operação. As respostas orientam uma decisão; não existe uma escolha correta para todos os ambientes.
Fontes consultadas: [2]
6. Priorize uma sequência de evolução
Depois de registrar fontes, consumidores, dependências, riscos e casos de uso, compare o que precisa acontecer primeiro. Uma sequência útil torna explícitas as premissas, as equipes envolvidas e as decisões ainda pendentes.
Na abordagem descrita pela SYSVISION para AI Data Foundation, descoberta e priorização antecedem o desenho de contratos, pipelines, APIs, CDC, camadas e produtos de dados. O escopo e a sequência dependem do ambiente, das prioridades e das capacidades internas.
Fontes consultadas: [1]
Checklist: o mapa está pronto para orientar a conversa?
Use estas perguntas para identificar lacunas antes de discutir ferramentas ou implementação.
- As fontes e seus responsáveis estão identificados?
- Os consumidores e as finalidades de uso estão claros?
- As dependências entre fluxos e transformações foram registradas?
- Os riscos, exceções e sinais a observar foram discutidos?
- As opções técnicas serão comparadas a partir desse contexto?
- As prioridades e perguntas em aberto estão visíveis?
Pergunta para o seu contexto
Qual fluxo de dados ainda depende de uma integração manual ou de conhecimento informal da equipe?
Fontes consultadas
- [1] SYSVISION — AI Data Foundation
Conteúdo relacionado: Mapeamento de fontes, consumidores, dependências, riscos e casos de uso antes de definir uma sequência de evolução e desenhar integrações conforme o ambiente.
- [2] SYSVISION — Soluções de dados e integração
Conteúdo relacionado: Capacidades publicadas de APIs, ETL/ELT, CDC, orquestração, monitoramento e tratamento de erros, descritas conforme as necessidades do ambiente.
Uma ideia que pode orientar a próxima decisão.
Um roteiro prático para relacionar fontes, consumidores, dependências e observabilidade antes de decidir como integrar dados.
Mapeie fontes, consumidores e finalidades antes de escolher mecanismos.
Registre dependências, riscos e perguntas em aberto.
Compare APIs, ETL/ELT e CDC conforme o ambiente e o caso de uso.
Artigo · Data & IA
Leve o tema para a sua realidade.
Uma conversa inicial ajuda a conectar o conceito às prioridades, dependências e capacidades do seu ambiente.